
ChatGPT показывает, как наша интуиция может подвести нас, когда мы пытаемся представить статистические закономерности, скрытые в полутриллионе слов текста и зафиксированные в 100 миллиардах параметров. Как и большинство людей, я бы никогда не догадался, что есть система, способная, например, написать Геттисбергскую речь в стиле Дональда Трампа. В массивах данных есть слои закономерностей, которые непостижимы для нас, людей. На меня произвело большое впечатление, что ChatGPT может генерировать правдоподобную, релевантную и хорошо структурированную прозу без какого-либо понимания мира — без явных целей, четко выраженных фактов или других вещей, которые, как можно было бы подумать, необходимы для создания осмысленного текста.
Впечатление, которое производит его компетентность, делает ошибки еще более поразительными. ChatGPT уверенно выдумывает, что у США было четыре женщины-президента, включая Люси Бейнс Джонсон в 1973–1977 годах. Он совершает элементарные с точки зрения здравого смысла ошибки. Уже 25 лет я начинаю свой вводный курс психологии с демонстрации того, как лучший из доступных на сегодняшний день искусственных интеллектов оказывается бессильным перед обычным здравым смыслом. В этом году я боялся, что эта часть лекции устареет, потому что примеры, которые я приводил, окажутся под силу ChatGPT. Но мои опасения оказались напрасны. Когда я спросил ChatGPT «Если Мейбл была жива в 9 утра и в 5 вечера, была ли она жива в полдень?», он ответил: «Не указано, была ли Мейбл жива в полдень. Известно, что она жива в 9 и 5, но информации о полдне нет». Таким образом, он не понимает базовых фактов о мире — он не знает, что люди живут непрерывными промежутками времени и после смерти не воскресают, — потому что он никогда не сталкивался с текстом, в котором это было бы явно указано. (В его защиту: он знал, что золотые рыбки не носят трусов.) Мы имеем дело с чуждым человеку интеллектом, способным на удивительные достижения, но не в манере, свойственной нашему разуму. Нам не нужно читать пол триллиона слов текста (если читать по три слова в секунду восемь часов в день, это займет 15 000 лет), чтобы разговаривать или решать проблемы. Тем не менее впечатляет, как много можно извлечь из статистических закономерностей очень высокого порядка, основанных на огромных наборах данных.
Я считаю, что это так же бессмысленно, как не имеет смысла «универсальная машина». Мы можем представить всевозможные суперспособности, такие как полеты Супермена, неуязвимость и рентгеновское зрение, но это не значит, что они могут быть реализованы физически. Точно так же мы можем фантазировать о суперинтеллекте, который найдет способ сделать нас бессмертными, или принести мир во всем мире, или захватить Вселенную. Но реальный интеллект состоит из набора алгоритмов для решения конкретных задач в конкретных условиях. То, что у нас есть сейчас и, вероятно, останется в будущем, — это устройства, которые превосходят людей в способности решать некоторые задачи, но не все.
Не больше, чем скачивание курсовых работ из интернета. Колледж попросил нас напомнить студентам, что кодекс чести запрещает сдавать работы, которые они не писали сами. Я не наивен; я знаю, что некоторые студенты Гарварда могут быть откровенными лжецами, но я не думаю, что таких много. Кроме того, пока что многие тексты ChatGPT легко распознать, потому что он использует цитаты и ссылки, которых не существует.
Страх перед новыми технологиями всегда вызван сценариями самого худшего, что может случиться, без учета тех контрмер, которые обязательно возникнут в реальном мире. Для больших языковых моделей такими контрмерами станут скептицизм по отношению к автоматически сгенерированному контенту (журналисты уже перестали использовать трюк, при котором ChatGPT пишет их колонки о ChatGPT, потому что читатели его раскусили), профессиональные и моральные ограничения (например, кодекс чести Гарварда), а также, возможно, технологии, которые будут маркировать или выявлять использование LLM. Есть и другие способы сопротивления. Один из них заключается в том, что мы интуитивно чувствуем причинно-следственные связи во взаимоотношениях с людьми. Коллекционер может заплатить $100 000 за клюшки для гольфа Джона Ф. Кеннеди, хотя они неотличимы от любых других клюшек для гольфа того времени. Запрос на подлинность еще сильнее в случае таких интеллектуальных продуктов, как рассказы и редакционные статьи: осознание того, что их написал реальный человек, влияет на их статус и ценность. Другой источник сопротивления — очевидные ошибки LLM, такие как утверждение, что измельченное стекло набирает популярность как диетическая добавка или что девять женщин могут родить ребенка за один месяц. По мере того как системы будут улучшаться благодаря обратной связи (которая часто идет из клик-ферм, расположенных в бедных странах), таких ошибок будет меньше, но, учитывая бесконечные возможности, они все равно будут возникать. И, что важно, физических следов, которые бы позволили нам проверять факты, не будет. Вы можете выяснить, какими источниками пользовался человек, но в LLM «факт» размазан по миллиардам крошечных корректировок количественных переменных, и его источник невозможно проверить. Тем не менее существует множество видов шаблонных текстов, которые LLM генерирует так же легко, как и человек, и это может быть полезно. Возможно, не стоит оплачивать рабочие часы дорогого адвоката, который составит для вас завещание или бракоразводное соглашение, ведь их можно сгенерировать автоматически.
Один из примеров — использование ChatGPT в качестве семантической поисковой системы. Нынешние поисковые системы работают со строковым типом данных. Сейчас, если вам нужна идея, а не последовательность символов, нет хорошего способа ее найти. Настоящая семантическая поисковая система, в отличие от LLM, имела бы концептуальную модель мира. Она бы включала символы для людей, мест, объектов и событий, а также представления о целях и причинно-следственных связях, что больше похоже на работу человеческого разума. Но как просто инструмент, как поисковая система для получения полезной информации LLM может быть чрезвычайно полезной — при условии, что перестанет выдумывать.
Я сомневаюсь, что улучшения будут экспоненциальными, но они будут происходить. И, как и в случае с использованием компьютеров, дополняющих человеческий интеллект, начиная с вычислений и ведения записей в 1960-х годах, поисковых систем в 1990-х и так далее, наши возможности возрастут. Мы признали, что наши способности запоминать и считать ограниченны, а теперь признаем, что поиск и обработка большого объема информации — это то, что мы можем делать хорошо, но ИИ может делать лучше. Поскольку LLM устроены иначе, чем мы, они могут помочь нам лучше понять природу человеческого интеллекта. Они могут углубить наше понимание устройства человеческого сознания, когда мы будем сравнивать его с системами, устроенными по тому же принципу, но превосходящими его в некоторых аспектах и уступающими в других.
Полную версию читайте по ссылке
В 2026 году конкурс также принимает поэтические переводы с удмуртского языка на русский
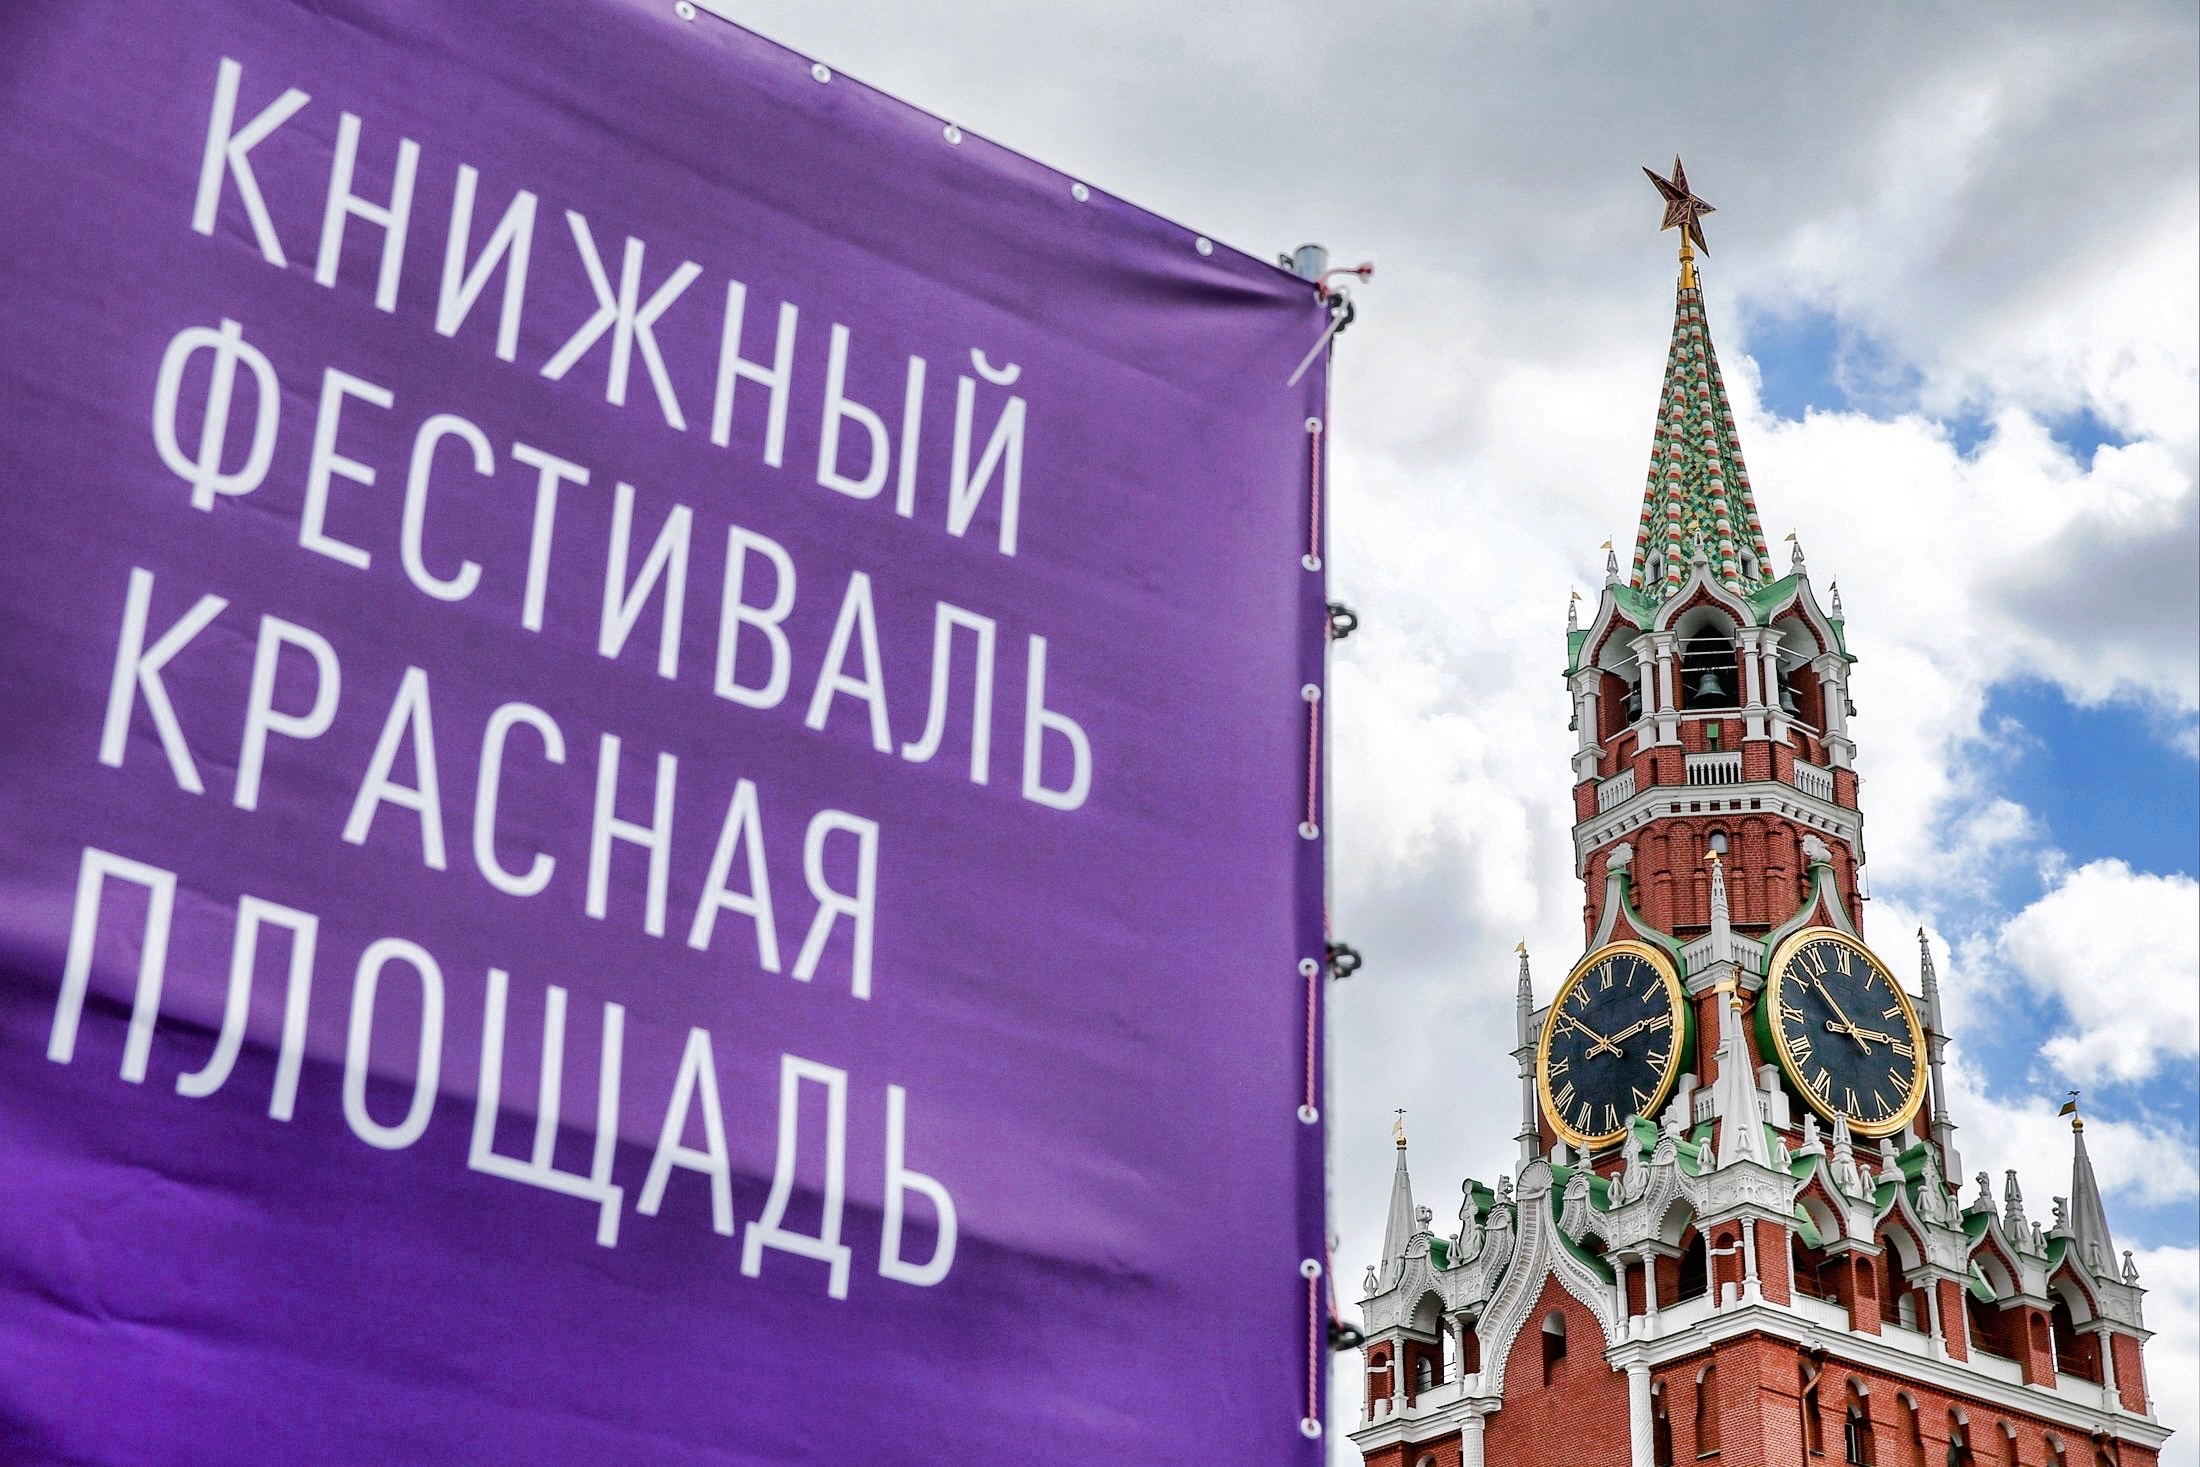
Книжный фестиваль «Красная площадь» пройдёт 6 по 9 июня